Ein Problem, das die meisten erst bemerken, wenn es zu spät ist.
Immer mehr Geschäftsprozesse laufen über KI: Verträge, Kundenkorrespondenz, Personalunterlagen, Patientendaten, Bürgeranliegen. Sobald personenbezogene Daten in diese Abläufe geraten (Namen, Adressen, Telefonnummern, Diagnosen, Bankverbindungen), befindet sich das Unternehmen automatisch im Anwendungsbereich der DSGVO und trägt die damit verbundene Verantwortung.
Der übliche Weg, dieses Problem zu „lösen“: Man bittet im Prompt das Sprachmodell selbst, keine persönlichen Daten zu nennen oder sie sorgfältig zu anonymisieren. Das ist intuitiv einleuchtend, und genau deshalb so verbreitet. Das Problem: Diese Lösung hält einer Prüfung nicht stand.
Ein Sprachmodell ist ein probabilistisches System. Es kann eine Anweisung in 95 von 100 Fällen befolgen und in den übrigen fünf versagen, und zwar unvorhersehbar: bei einer unerwarteten Formulierung, einem seltenen Namen oder einer ungewöhnlichen Dokumentstruktur. Für die meisten Aufgaben ist diese Fehlerquote vertretbar. Für personenbezogene Daten nicht: Eine Aufsichtsbehörde, ein Auditor oder ein betroffener Kunde interessiert sich nicht für Statistik. Ihn interessiert der konkrete Fall des Datenlecks.
Kurz gesagt
Personenbezogene Daten lassen sich in KI-Systemen nicht verlässlich per Prompt-Anweisung schützen, denn ein Sprachmodell arbeitet probabilistisch und verstößt gelegentlich auch gegen klare Vorgaben. Wir lagern den Schutz deshalb in eine eigene, unabhängig prüfbare Schutzschicht aus, die Daten nach festen Regeln bereinigt oder blockiert, und testen sie mit Grenzfällen, in beide Richtungen und mit unabhängigen Kontrollsätzen.
Unser Prinzip: Datenschutz darf nicht davon abhängen, ob das Modell die Anweisung „versteht“
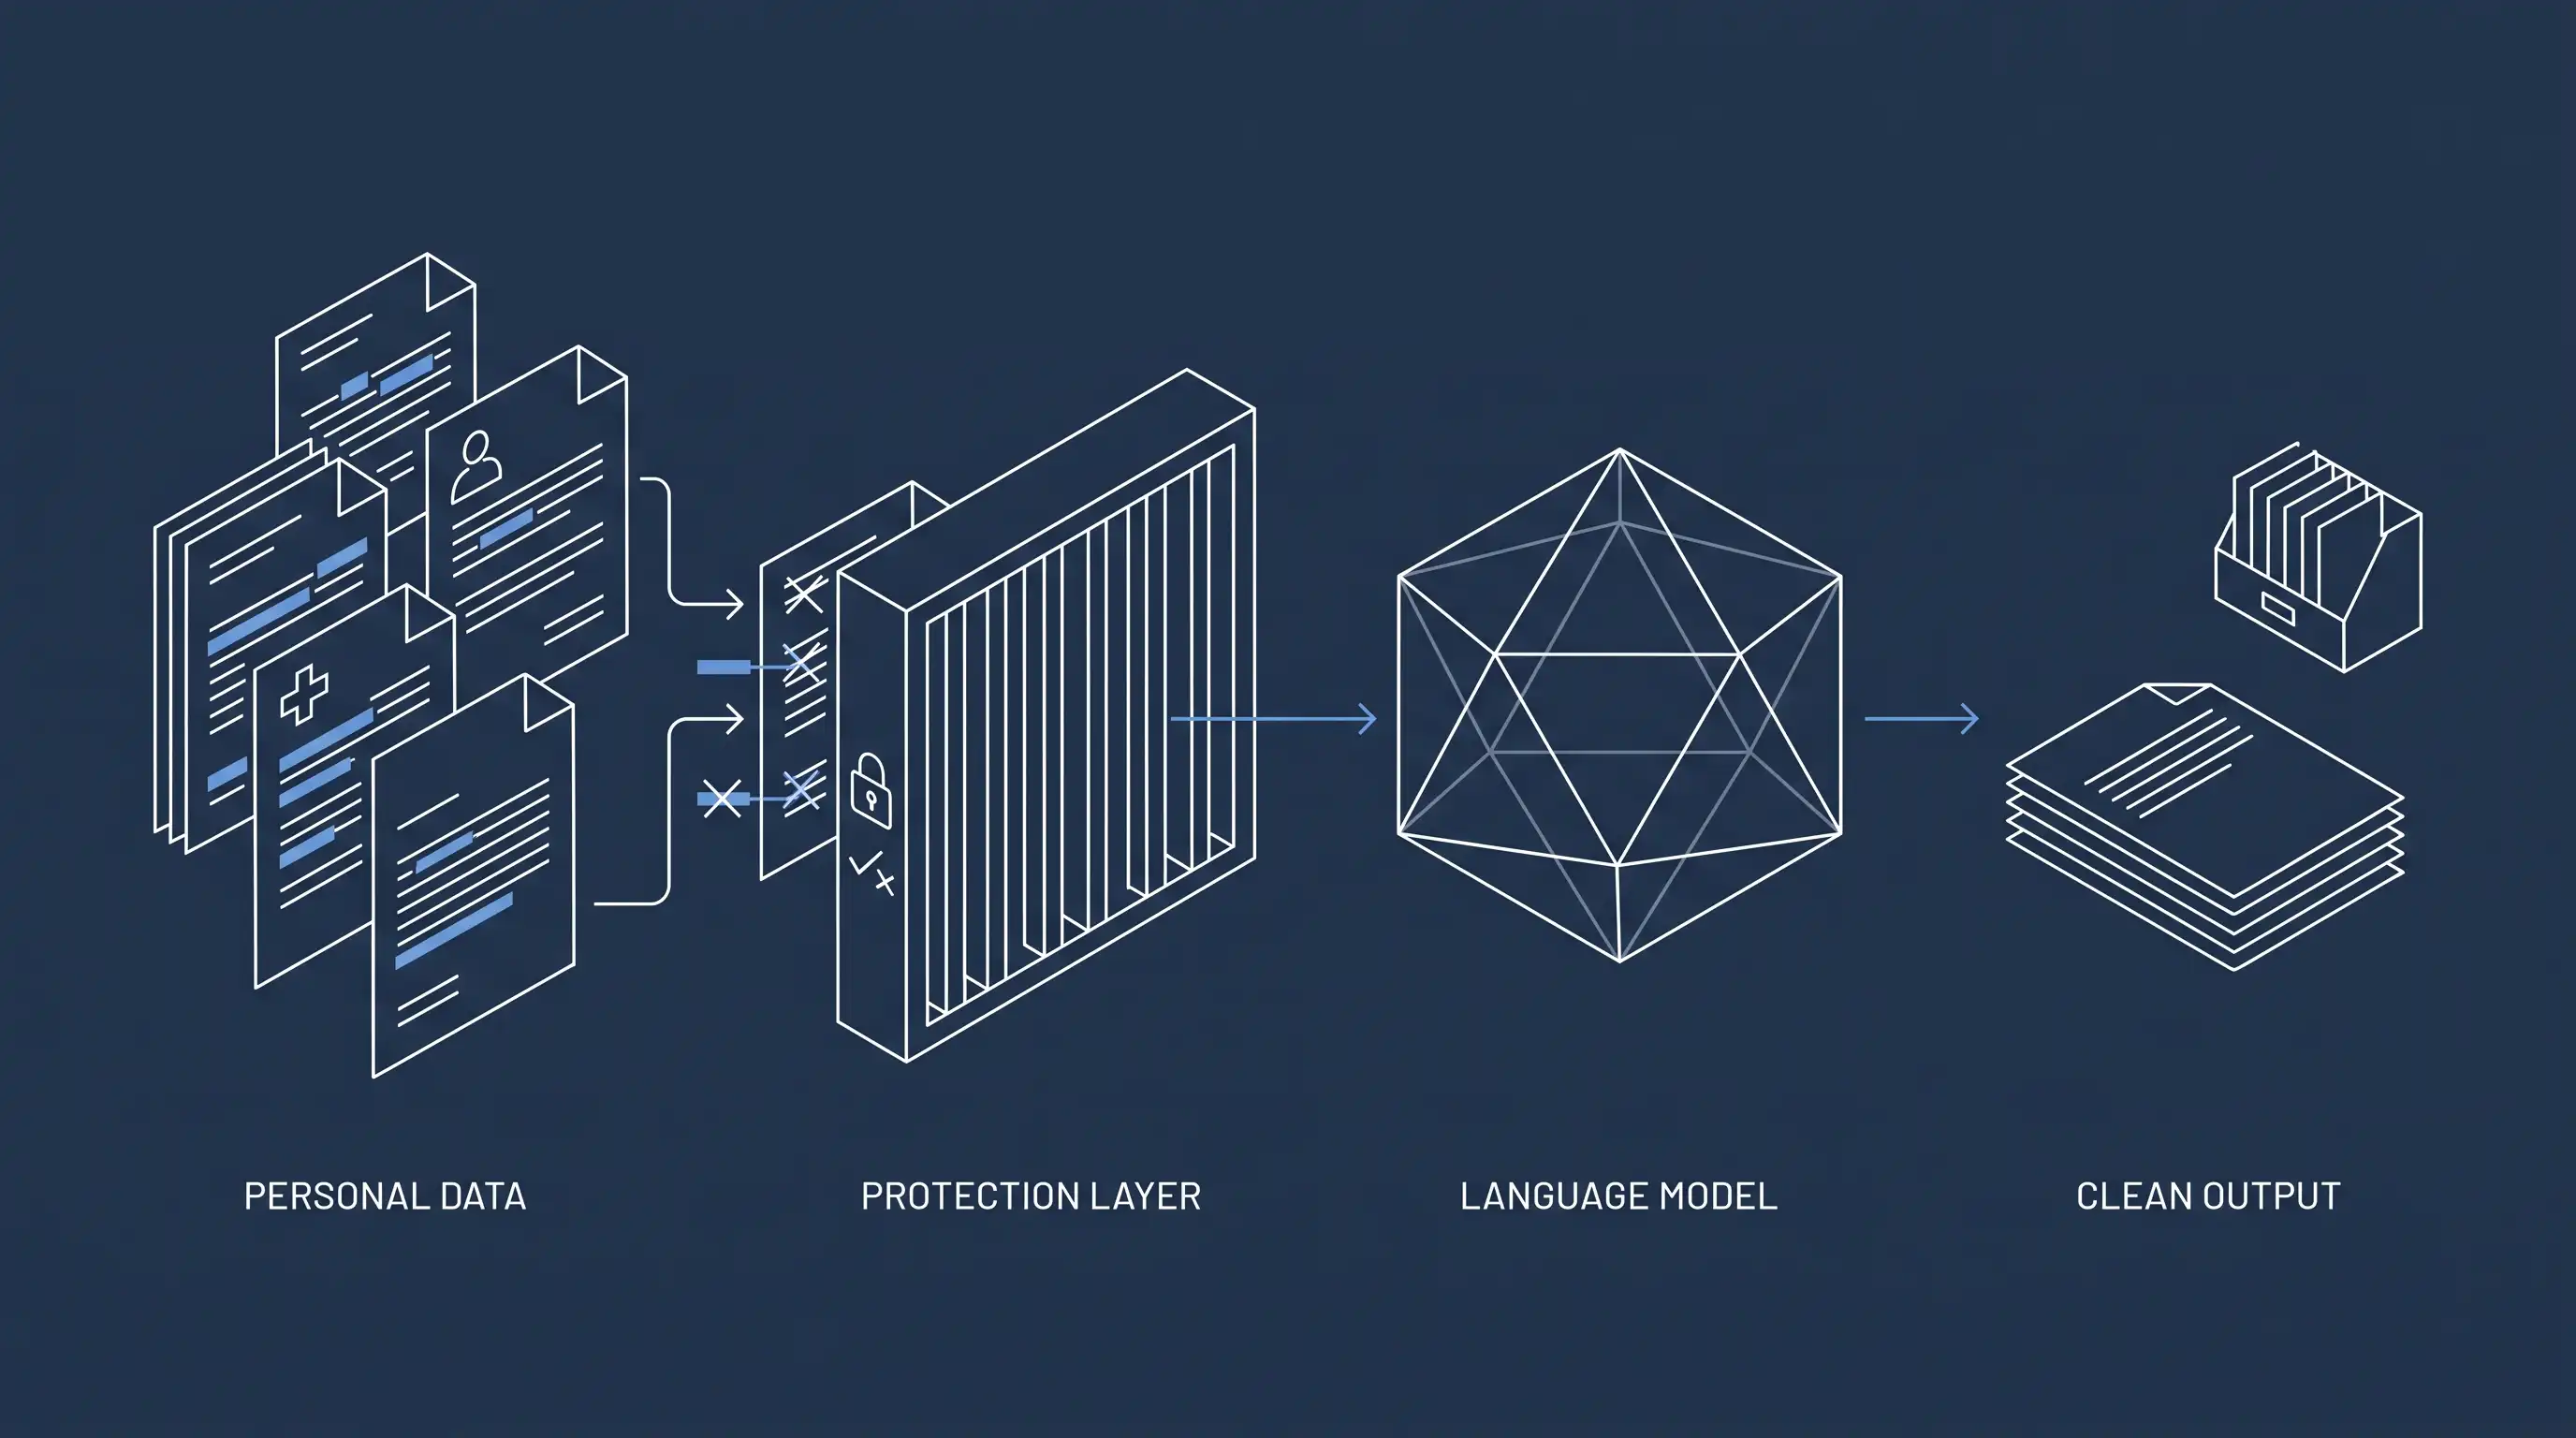
Beim Bau von KI-Produkten, die mit sensiblen Informationen arbeiten, folgen wir einer einfachen Regel: Eine sicherheitskritische Funktion darf nicht darauf beruhen, dass sich ein neuronales Netz „im Großen und Ganzen richtig verhält“. Sie muss in einen eigenen, unabhängig prüfbaren Mechanismus ausgelagert werden, der Daten entweder garantiert bereinigt oder ihre Weitergabe entlang der Kette blockiert. Ohne Zwischenzustände und ohne Hoffnung auf Glück.
In der Praxis bedeutet das eine architektonische Trennung der Rollen:
- Das Sprachmodell übernimmt, wofür es gut ist: Bedeutung verstehen, Antworten erzeugen, mit Inhalten arbeiten.
- Eine separate Schutzschicht ist für genau eine Sache zuständig, die Kontrolle personenbezogener Daten, und arbeitet nach Regeln, die sich von Durchlauf zu Durchlauf nicht ändern und nicht davon abhängen, wie eine Anfrage formuliert ist.
Diese Trennung ist kein technisches Detail, sondern eine bewusste Architekturentscheidung. Sie sorgt dafür, dass ein Produkt auf die Frage „Wie garantieren Sie den Schutz personenbezogener Daten?“ eine inhaltliche Antwort hat und nicht nur den Verweis auf die Sorgfalt des Modells.
Den Prototyp eines solchen PII-Filters hat unser Ingenieur Sergey Kostyaev entwickelt.
Wie das in der Praxis geprüft wird
Die Aussage „Unser System ist geschützt“ ist nichts wert ohne systematische Prüfung. Bevor ein solcher Schutzmechanismus als bereit für reale Kundendaten gilt, durchläuft er:
- Eine große Menge an Testszenarien, bewusst so konstruiert, dass sie nicht nur die offensichtlichen Fälle enthalten, sondern auch Grenzfälle, Provokationen und absichtlich verwirrende Formulierungen. Genau die Situationen, in denen eine „höfliche Anweisung“ an das Modell am häufigsten versagt.
- Eine Prüfung in beide Richtungen: Das System muss nicht nur zuverlässig entfernen, was es entfernen muss, sondern auch Texte unangetastet lassen, in denen keine personenbezogenen Daten stehen. Übermäßige, aggressive Bereinigung gilt ebenfalls als Fehler, weil sie das Produkt unbrauchbar macht.
- Unabhängige Kontrollsätze, die sich nicht mit den Haupttests überschneiden, damit ausgeschlossen ist, dass das System nur bestimmte Beispiele „auswendig gelernt“ hat, statt die Regel einzuhalten.
- Ehrliche Dokumentation bekannter Grenzen. Hat ein Mechanismus eine dokumentierte Leistungsgrenze, wird sie offen berichtet und nicht hinter einer bequemen Statistik versteckt. Transparenz über die Grenzen eines Systems ist für uns Teil des Vertrauens in das Produkt, nicht seine Schwäche.
Wo es sinnvoll ist, kommt zusätzlich ein kompaktes Modell zum Einsatz, das lokal in der Infrastruktur des Auftraggebers läuft, ohne Datenübertragung an externe Cloud-Dienste. Eine solche Konfiguration wird erst freigegeben, nachdem sie dieselbe strenge Prüfung durchlaufen und ein stabiles Ergebnis bei fixierter, reproduzierbarer Konfiguration gezeigt hat, nicht bei der „aktuellsten Version, die heute verfügbar ist“.
Warum das für Sie als Auftraggeber relevant ist
Wenn in Ihrem Produkt, einem internen Prozess oder einem Kundenservice KI mit personenbezogenen oder anderweitig sensiblen Daten in Berührung kommt, taucht früher oder später eine von drei Fragen auf:
- Von Aufsichtsbehörde oder Auditor: Wie können Sie die Einhaltung der Datenschutzanforderungen nachweisen?
- Von Kunden oder Partnern: Was passiert mit den Daten innerhalb Ihres Systems?
- Vom eigenen Team: Was geschieht, wenn das Modell eines Tages einen Fehler macht?
Die Antwort „Wir haben die KI gebeten, sorgfältig zu sein“ besteht keine dieser Prüfungen. Die Antwort „Wir haben einen eigenen, getesteten, unabhängig prüfbaren Kontrollmechanismus“ besteht sie.
Häufige Fragen
Warum reicht eine Anweisung im Prompt nicht für den Datenschutz?
Ein Sprachmodell ist ein probabilistisches System. Es kann eine Anweisung in 95 von 100 Fällen befolgen und in den übrigen fünf unvorhersehbar versagen, etwa bei einer ungewöhnlichen Formulierung, einem seltenen Namen oder einer untypischen Dokumentstruktur. Bei personenbezogenen Daten interessiert eine Aufsichtsbehörde nicht die Statistik, sondern der konkrete Fall des Datenlecks.
Wie funktioniert eine separate Schutzschicht?
Das Sprachmodell versteht Inhalte und erzeugt Antworten. Eine separate Schutzschicht kontrolliert ausschließlich personenbezogene Daten, nach Regeln, die sich von Durchlauf zu Durchlauf nicht ändern und nicht davon abhängen, wie eine Anfrage formuliert ist. Sie bereinigt Daten garantiert oder blockiert ihre Weitergabe, ohne Zwischenzustände.
Wie wird so ein Schutzmechanismus getestet?
Er durchläuft eine große Menge an Testszenarien mit Grenzfällen und bewusst verwirrenden Formulierungen, wird in beide Richtungen geprüft (entfernt er, was er entfernen muss, und lässt er Text ohne personenbezogene Daten unberührt?) und wird an unabhängigen Kontrollsätzen gemessen, damit er keine Beispiele auswendig lernt. Bekannte Grenzen werden offen dokumentiert.
Kann der Schutz lokal laufen, ohne Daten an Cloud-Dienste zu senden?
Ja, wo es sinnvoll ist, kommt ein kompaktes Modell zum Einsatz, das lokal in der Infrastruktur des Auftraggebers läuft. Es wird erst freigegeben, nachdem es dieselbe Prüfung bestanden und bei fixierter, reproduzierbarer Konfiguration ein stabiles Ergebnis gezeigt hat.
Welche Fragen stellen Aufsichtsbehörden, Kunden und das eigene Team?
Die Aufsichtsbehörde oder der Auditor fragt, wie Sie die Einhaltung der Datenschutzanforderungen nachweisen. Kunden und Partner fragen, was mit ihren Daten im System passiert. Das eigene Team fragt, was geschieht, wenn das Modell einen Fehler macht. Ein eigener, getesteter, unabhängig prüfbarer Kontrollmechanismus beantwortet alle drei.
Wenn das für Sie relevant ist
Wir entwerfen und implementieren solche Schutzschichten als Teil von KI-Produkten für unsere Portfoliounternehmen und Partner, von der Analyse, welche Daten und Risiken in Ihrem Prozess vorkommen, bis zur fertigen, in das Produkt integrierten Lösung.
Wenn Ihr Unternehmen über KI-Systeme mit personenbezogenen oder sensiblen Daten arbeitet und Sie verstehen möchten, worauf deren Schutz tatsächlich beruht, schreiben Sie uns an info@bergstone.de. Wir besprechen Ihren konkreten Fall.